프롬프트 캐싱 글은 대부분 “긴 시스템 프롬프트를 캐싱하면 90% 싸진다”에서 끝납니다. 정작 중요한 건 어디에 cache_control을 박느냐와 몇 번 재사용해야 본전이냐입니다. 잘못 박으면 캐싱을 켜고도 요금이 25% 늘어납니다.
캐시 쓰기 1.25배, 읽기 0.1배 — 이 비대칭이 전략을 정한다
캐싱은 할인이 아니라 선불입니다. 프리픽스를 캐시에 처음 쓸 때 기본 입력 단가보다 비싸게 내고, 이후 읽을 때 싸게 냅니다.
| 캐시 연산 | 배율 | 유효 시간 |
|---|---|---|
| 5분 캐시 쓰기 | 기본 입력가 × 1.25 | 5분 |
| 1시간 캐시 쓰기 | 기본 입력가 × 2 | 1시간 |
| 캐시 읽기(히트) | 기본 입력가 × 0.1 | 직전 쓰기와 동일 |
Claude Opus 5 기준으로 환산하면 입력 $5, 5분 쓰기 $6.25, 1시간 쓰기 $10, 읽기 $0.50(모두 100만 토큰당)입니다. “90% 절감”은 여기서 나온 숫자입니다. 읽기 배율 0.1배는 캐시에 얹힌 프리픽스 입력 토큰에만 적용됩니다. 출력 토큰, 브레이크포인트 뒤의 가변 입력은 그대로 제값을 냅니다. 청구서 전체가 90% 줄어드는 게 아닙니다.
몇 번 재사용해야 본전인가
같은 프리픽스를 N번 보낸다고 하면 캐싱 없이 드는 비용은 N(배율 1.0 × N회)이고, 캐싱을 켜면 쓰기 1회 + 읽기 N−1회가 됩니다.
5분 TTL:   1.25 + 0.1 × (N-1) < N   →   N > 1.28   →   N ≥ 2
1시간 TTL:    2 + 0.1 × (N-1) < N   →   N > 2.11   →   N ≥ 3
5분 캐시는 히트가 한 번만 나도 이득이고, 1시간 캐시는 두 번 나야 이득입니다. 반대로 읽으면 이렇게 됩니다.
- 5분 캐시를 썼는데 재사용이 0회: 1.25배 → 25% 손해
- 1시간 캐시를 썼는데 읽기가 1회뿐: 2 + 0.1 = 2.1배 vs 2.0배 → 5% 손해
TTL은 응답 생성 시간까지 포함해 요청 시작 시점부터 카운트됩니다. 5분 안에 다음 요청이 확실히 들어오는 트래픽이 아니라면 1시간 TTL을 쓰되, 위 계산으로 히트 2회가 보장되는지 먼저 확인해야 합니다.
Opus 5로 프리픽스 20,000 토큰을 100회 재사용하는 에이전트 루프를 계산하면 이렇습니다(공식 단가 기준, 히트율 100% 가정).
| 계산 | 비용 | |
|---|---|---|
| 캐싱 없음 | 2,000,000 × $5 / 1M | $10.00 |
| 캐시 쓰기 1회 | 20,000 × $6.25 / 1M | $0.125 |
| 캐시 읽기 99회 | 1,980,000 × $0.50 / 1M | $0.99 |
| 합계 | $1.115 (약 89% 절감) |
브레이크포인트는 tools → system → messages 순서로
캐시는 프리픽스 매칭입니다. 프리픽스는 항상 tools → system → messages 순서로 만들어지고, 앞쪽이 1바이트라도 바뀌면 그 뒤 캐시는 전부 무효화됩니다. 그래서 배치 순서가 곧 전략입니다.
- 툴 정의 — 가장 안 변하는 것. 마지막 툴에
cache_control을 걸면 그 앞의 모든 툴이 한 덩어리로 캐싱됩니다. - 시스템 프롬프트 — 고정 지시문. 여기에 타임스탬프나 사용자 이름을 넣는 순간 캐시가 매 요청 깨집니다.
- 고정 문서 — 스펙, 스키마, 예제처럼 세션 내내 그대로인 것.
- 대화 이력 — 늘어나는 부분. 마지막 브레이크포인트는 보통 여기에 둡니다.
브레이크포인트는 요청당 최대 4개이고, 각 브레이크포인트에서 최대 20블록까지 거슬러 올라가며 캐시를 찾습니다. 세밀한 제어가 필요 없다면 요청 최상위에 cache_control을 한 번 넣는 자동 캐싱이 낫습니다. 대화가 길어질수록 브레이크포인트를 알아서 앞으로 밀어줍니다.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=16000,
    system=[
        {
            "type": "text",
            "text": STABLE_SYSTEM_PROMPT,   # 절대 안 바뀌는 부분만
            "cache_control": {"type": "ephemeral", "ttl": "1h"},
        },
    ],
    messages=messages,   # 가변 입력은 브레이크포인트 뒤로
)
툴 정의를 어떻게 쪼개야 캐시가 안 깨지는지는 Claude API 툴 스키마 구조에서 더 다뤘습니다.
모델별 최소 캐시 토큰 — 짧으면 조용히 안 걸린다
프리픽스가 모델별 최소 토큰보다 짧으면 에러 없이 캐싱이 그냥 안 되고, 요금만 정상 청구되면서 cache_read_input_tokens는 0으로 남습니다.
| 모델 | 최소 캐시 토큰 |
|---|---|
| Claude Opus 5 | 512 |
| Claude Sonnet 5, Claude Opus 4.8 | 1,024 |
| Claude Opus 4.7 | 2,048 |
| Claude Opus 4.6, Claude Haiku 4.5 | 4,096 |
싼 모델일수록 문턱이 높다는 게 함정입니다. 비용을 아끼려고 Haiku 4.5로 내렸는데 프리픽스가 2,000 토큰이면 캐싱은 아예 안 걸립니다.
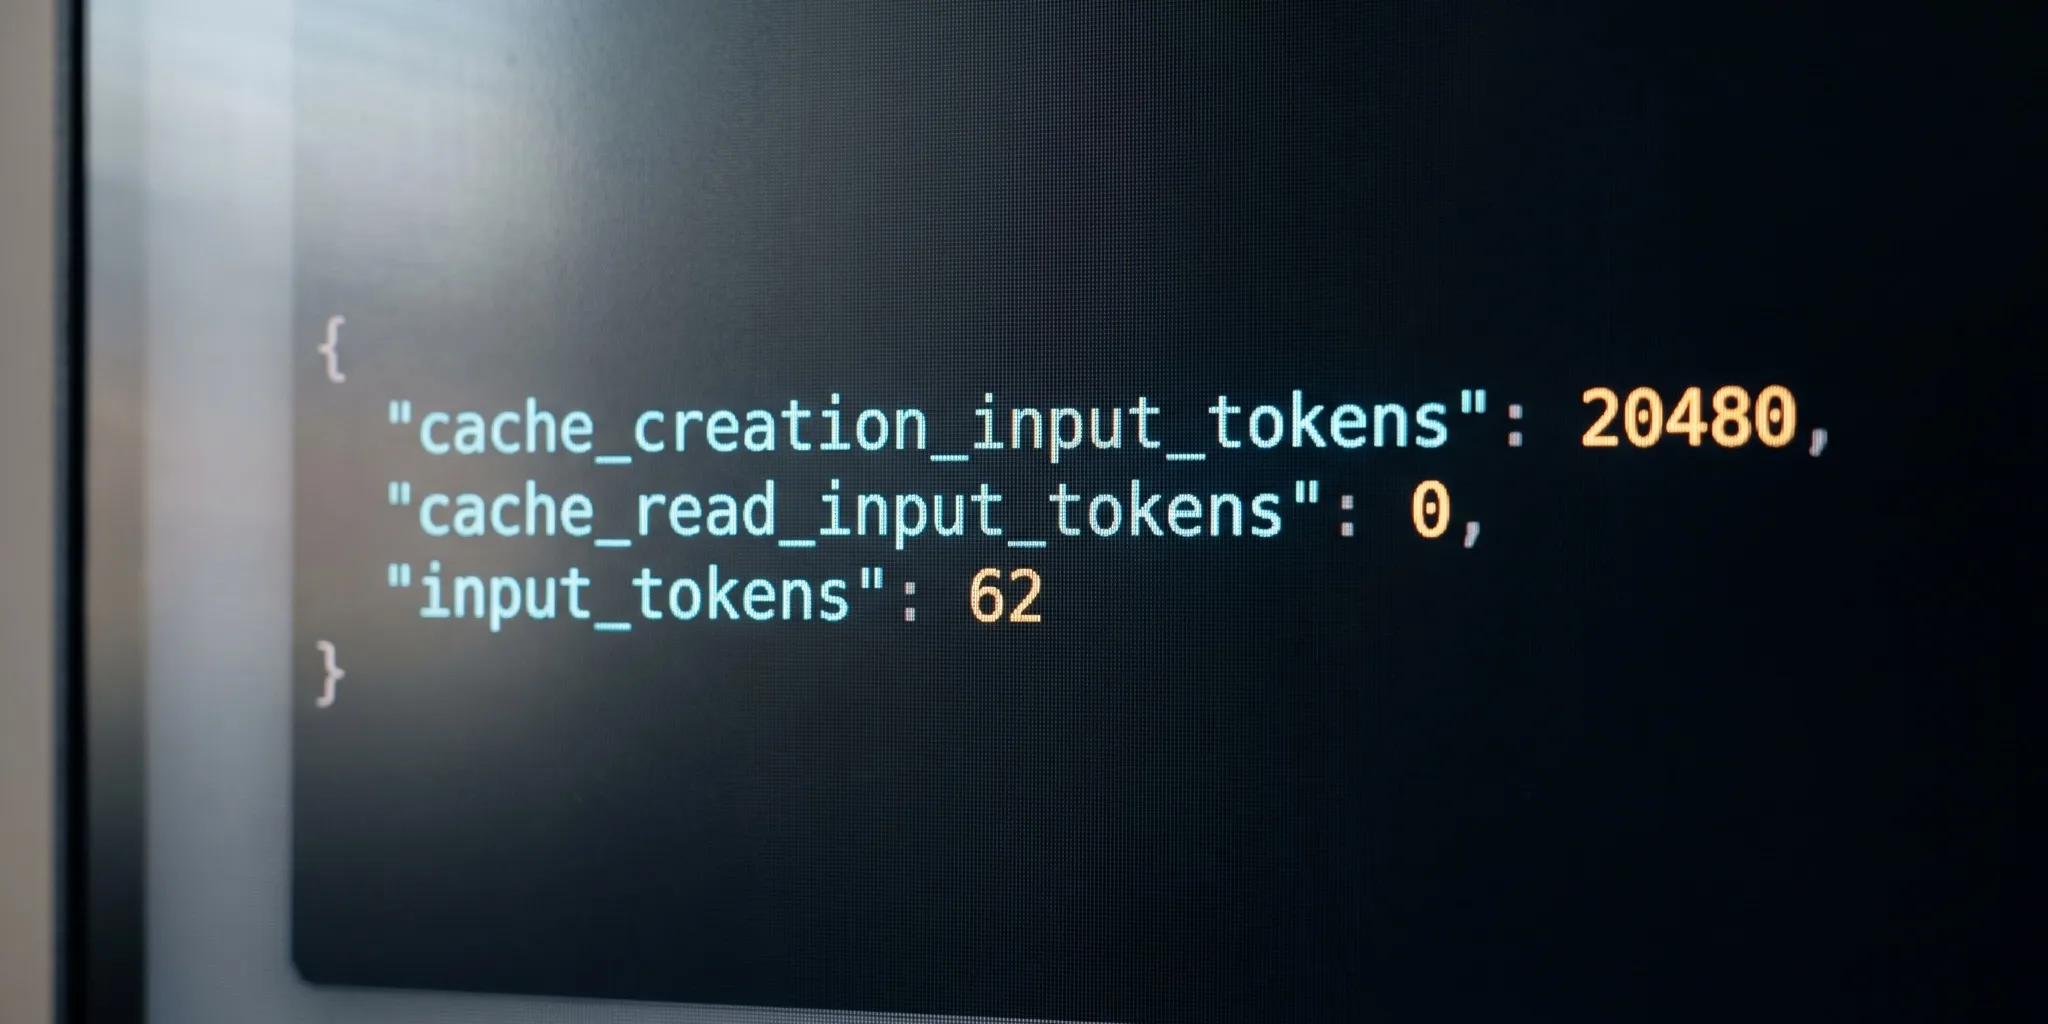
캐시가 걸렸는지는 usage 세 필드로 확인한다
{
  "usage": {
    "cache_creation_input_tokens": 20480,
    "cache_read_input_tokens": 0,
    "input_tokens": 62
  }
}
여기서 input_tokens는 마지막 브레이크포인트 뒤의 토큰만 세는 것이지, 전체 입력이 아닙니다. 캐싱을 켠 뒤 input_tokens가 62로 떨어진 걸 보고 “토큰이 줄었다”고 읽으면 오독입니다. 실제 입력량은 이렇게 더해야 나옵니다.
total_input = cache_read_input_tokens + cache_creation_input_tokens + input_tokens같은 프리픽스로 반복 호출하는데 cache_read_input_tokens가 계속 0이면 무언가가 매번 캐시를 깨고 있다는 뜻입니다.
캐시를 날리는 안티패턴
- 프리픽스 안의 가변값 —
datetime.now(), 요청 ID, 사용자 이름. 가장 흔한 원인입니다. - 툴 정의 변경 — 툴이 하나만 바뀌어도 tools·system·messages 캐시가 전부 무효화됩니다. 툴 목록을 동적으로 조립한다면 직렬화 순서까지 고정해야 합니다.
- JSON 키 순서 — 딕셔너리를 그때그때 직렬화하면 바이트가 달라집니다.
- 요청 중간의 설정 변경 —
tool_choice를 바꾸면 messages 캐시가, 이미지를 넣고 빼면 system 캐시부터 깨집니다.effort를 대화 도중에 올리는 것도 같은 효과를 냅니다.
프리픽스를 “절대 안 바뀌는 것 → 가끔 바뀌는 것 → 매번 바뀌는 것” 순으로 정렬해두는 설계가 결국 정답입니다. 이 원칙은 컨텍스트 자체를 설계하는 하네스 엔지니어링 관점과 같습니다.
MCP 툴 정의가 먹는 토큰
MCP 서버를 여러 개 붙이면 툴 정의만으로 수천~수만 토큰이 프리픽스에 얹힙니다. 문제는 크기 자체보다 변동성입니다. 서버 하나가 응답을 못 해 툴 목록이 달라지면 그날 캐시는 통째로 날아갑니다.
대응은 두 가지입니다. 마지막 툴에 cache_control을 걸어 툴 블록 전체를 한 덩어리로 캐싱하고, 안 쓰는 툴은 defer_loading: true로 미뤄 프리픽스에서 빼는 겁니다(단, 전부 지연시키면 400 에러가 납니다). 현재 컨텍스트에서 무엇이 자리를 차지하는지는 Claude Code의 /context로 바로 확인할 수 있습니다. 슬래시 명령어 정리에 다른 진단 명령어도 함께 정리해뒀습니다.
정리
- 캐싱은 선불이다. 5분 TTL은 히트 1회, 1시간 TTL은 히트 2회부터 이득이다.
- 브레이크포인트는 안 변하는 것 뒤에 둔다. 순서는 tools → system → messages로 고정돼 있다.
- 프리픽스가 모델 최소 토큰보다 짧으면 에러 없이 캐싱이 무시된다.
- 성공 여부는
cache_read_input_tokens로만 판단한다.input_tokens감소는 착시다.
수치는 2026년 9월 기준 공식 프롬프트 캐싱 문서와 가격표를 따랐습니다. 배율과 최소 토큰은 모델이 추가될 때마다 바뀌므로 적용 전에 확인하세요.