OpenAI가 사내에서 5개월짜리 실험을 했습니다. 결과는 이렇습니다.
- PR 약 1,500건, 코드 약 100만 줄
- 사람이 손으로 친 코드 0줄 (의도적으로)
- 엔지니어 3명으로 시작해 7명으로 확장
- 1인당 하루 평균 3.5 PR
여기서 눈여겨볼 건 100만 줄이 아니라 인원을 늘렸는데 1인당 처리량이 안 떨어졌다는 쪽입니다. 보통은 사람이 늘면 조율 비용 때문에 개인 생산성이 깎이거든요.
이걸 가능하게 한 게 하네스(harness)입니다.
프롬프트 → 컨텍스트 → 하네스
세 단계는 대체 관계가 아니라 감싸는 관계입니다.
| 프롬프트 엔지니어링 | 컨텍스트 엔지니어링 | 하네스 엔지니어링 | |
|---|---|---|---|
| 범위 | 프롬프트 한 개 | 추론 1회의 입력 전체 | 시스템 전체 |
| 지속 | 정적 | 런타임 동안 | 세션을 넘어 영속 |
| 핵심 질문 | 어떻게 말할까 | 무엇을 보여줄까 | 무엇을 막고 재고 고칠까 |
| 시기 | 2022~2023 | 2024~2025 | 2025~2026 |
가장 잘 알려진 비유는 이겁니다. “모델은 CPU고, 하네스는 OS다.” CPU를 더 좋은 걸로 갈아 끼워도 OS가 없으면 프로그램이 안 돌아갑니다. 반대로 OS가 잘 잡혀 있으면 CPU 세대가 올라갈 때마다 그 이득을 그대로 받습니다.
지금 모델을 바꾸는 건 우리 몫이 아니지만 OS를 짜는 건 우리 몫이에요.
모델을 그대로 두고 13.7점
말로만 하면 와닿지 않으니 최근 사례를 하나 보겠습니다. LangChain이 자사 코딩 에이전트를 Terminal Bench 2.0에서 52.8%에서 66.5%로 끌어올렸습니다. 모델은 gpt-5.2-codex로 고정한 채 하네스만 손봤습니다.
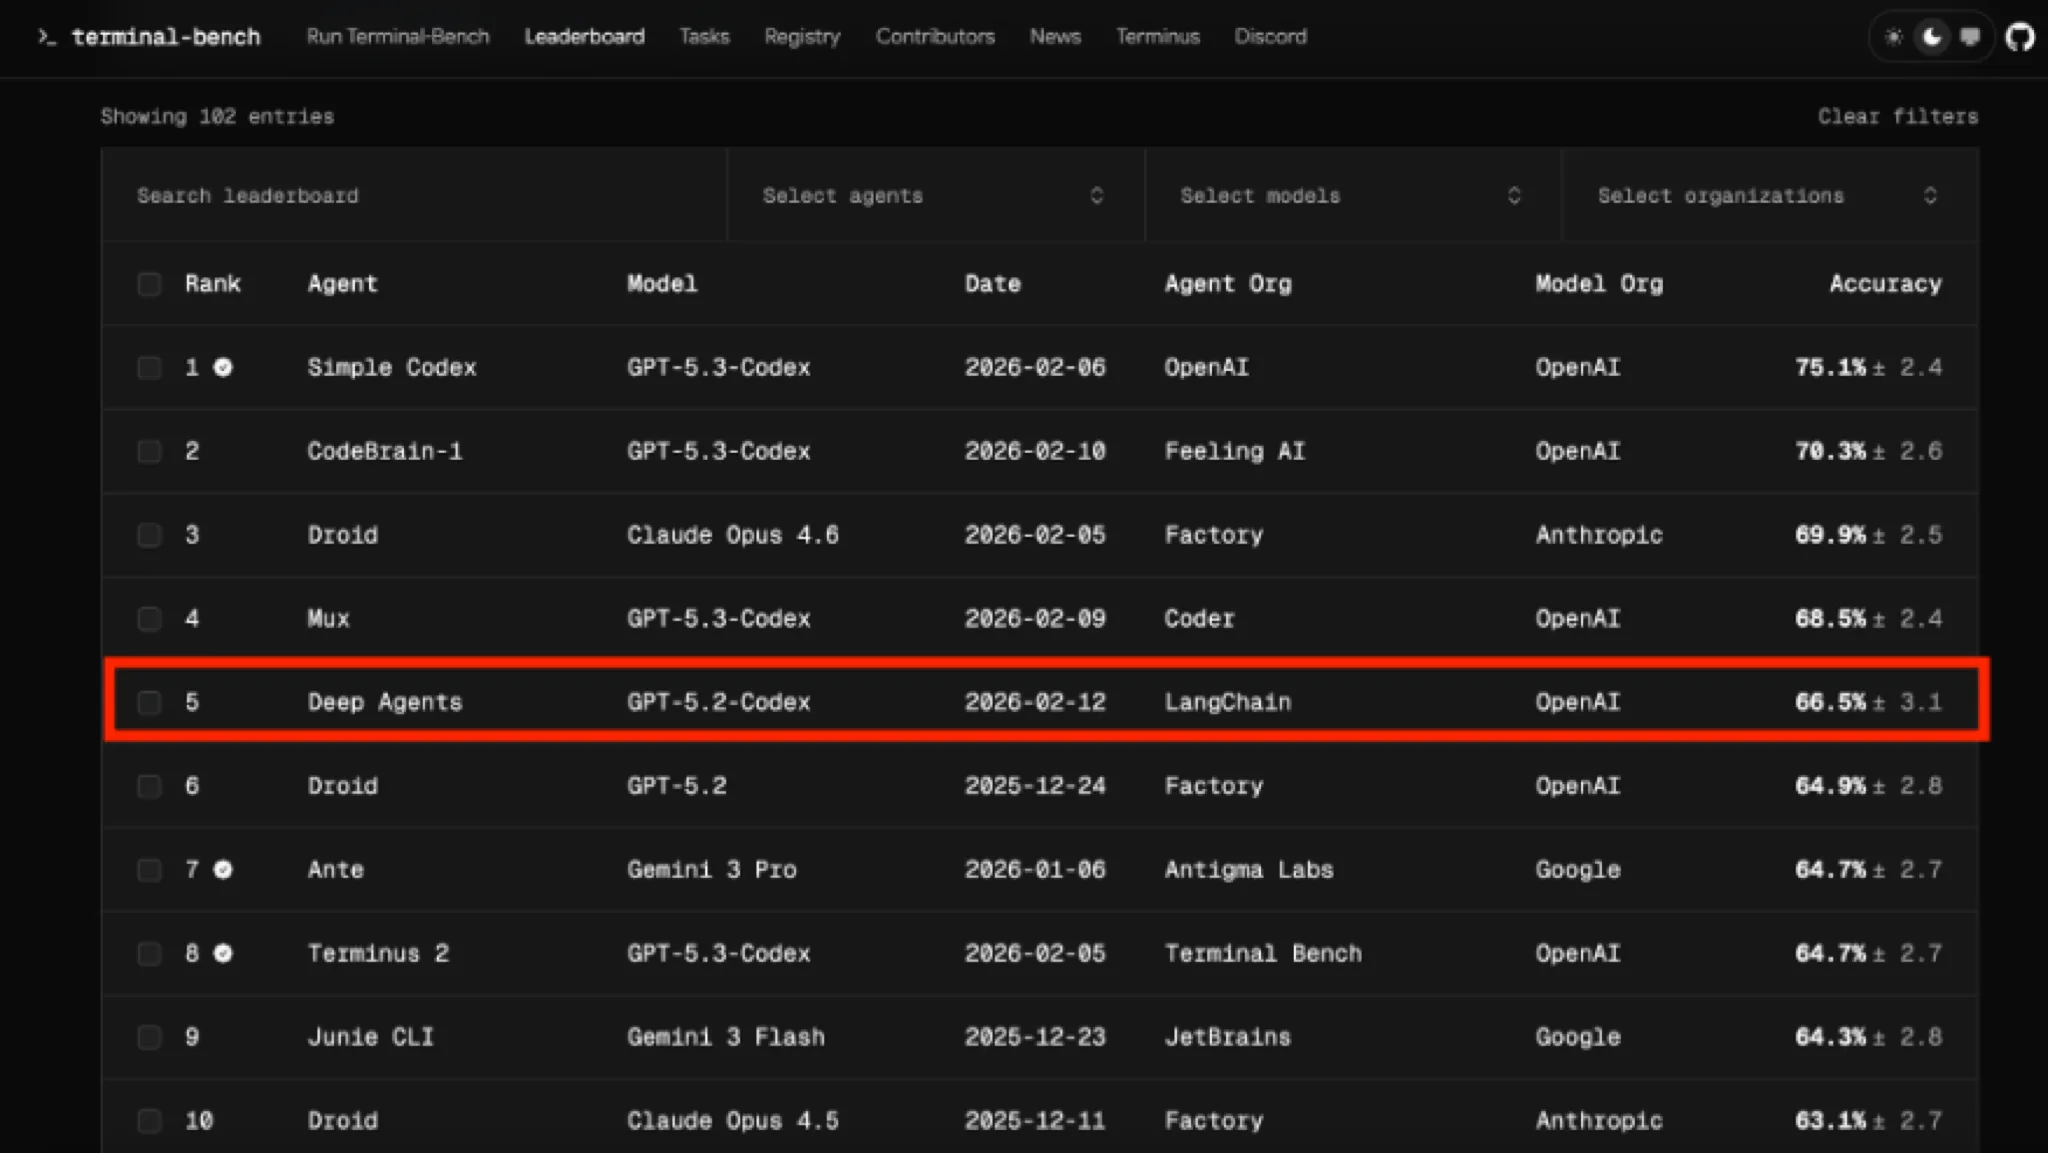
리더보드를 보면 의미가 더 분명해집니다. 상위권 대부분이 더 최신 모델을 쓰는데 5위는 한 세대 이전 모델입니다. 그 자리는 모델이 아니라 하네스가 만든 자리예요.
손댄 곳은 셋이었습니다. 스스로 결과를 검증하게 만드는 시스템 프롬프트, 에이전트가 자기 환경을 파악하도록 돕는 도구와 컨텍스트 주입, 그리고 같은 자리를 맴도는 패턴을 잡아내는 미들웨어 훅.
하네스를 구성하는 다섯 가지
- 가드레일 — 툴 접근 제어, 샌드박스 실행, 위험한 작업 앞의 승인 게이트
- 플랜과 스펙 — 작업 명세 템플릿, 작게 쪼갠 PR 단위
- 테스트·CI·리뷰 — 자동 테스트, 린터, 회귀 테스트 유지
- 평가(eval) — 에이전트 출력 품질을 재는 자체 기준
- 관측 — 구조화된 로그, 실패 유형 분류, 추적
안전 쪽에서 접근하면 구성이 조금 다릅니다. 채널톡은 가드레일, 데이터 거버넌스, 모니터링·피드백 루프 셋으로 정리하는데 결국 같은 말입니다. **AI의 힘을 누르는 게 아니라 방향을 잡아주는 마구(馬具)**라는 원래 뜻 그대로예요.
국내 사례: 토큰을 95% 줄인 방법
우아한형제들 기술블로그의 사례가 특히 구체적입니다. 팀은 AI가 코드를 짜기 전에 스스로 파일을 뒤지게 두지 않고, Node.js 전처리 스크립트로 필요한 메타데이터만 뽑아서 넘겼습니다.
| 도메인 규모 | AI가 직접 탐색 | 스크립트 요약 | 감소율 |
|---|---|---|---|
| 대형 (API 11개) | 41,944 bytes | 1,763 bytes | 95.8% |
| 중형 (API 4개) | 29,386 bytes | 668 bytes | 97.7% |
| 소형 (API 2개) | 9,749 bytes | 539 bytes | 94.5% |
작업당 평균 6,800 토큰이 절약됐고, AI가 파일을 뒤지느라 부르던 툴 호출이 4회에서 1회로 줄었습니다. 프롬프트를 잘 쓴 게 아니라 넘겨줄 데이터를 미리 다듬어 둔 결과입니다. 다듬은 데이터를 매 호출마다 다시 보내고 있다면, 그다음 단계는 프롬프트 캐싱으로 반복 전송 비용을 10분의 1로 낮추는 것입니다.
큰 규칙 파일 하나는 실패한다
OpenAI가 먼저 시도했다가 접은 방식이 “커다란 AGENTS.md 하나에 다 적기”입니다. 실패 이유가 명확해요. 컨텍스트는 희소 자원이라, 거대한 지침서가 정작 필요한 코드와 문서를 밀어냅니다.
그래서 바꾼 구조는 이렇습니다. AGENTS.md는 짧게 두고, 거기서 설계 문서·아키텍처 맵·실행 계획·품질 기준을 가리키게 합니다. 전부 저장소에 버전 관리되고요. 규칙 파일은 백과사전이 아니라 목차여야 합니다.
이 지침 파일들의 정체를 한 줄로 말하면 과거 실패의 기록입니다. 한 줄 한 줄이 에이전트가 예전에 틀렸던 지점이에요.
제 하네스는 3계층입니다
이론만 옮기면 재미없으니 제가 쓰는 구조를 그대로 공개합니다. 프로젝트마다 도구를 새로 만들지 않으려고 세 겹으로 나눴습니다.
Layer A  ~/.claude/skills/skillset-<lang>/    언어별 원시 동작
         run_pytest, tsc_check, flutter_analyze ...
Layer B  ~/.claude/agents/<lang>-base.md      언어 전문가 페르소나
         프로젝트는 전혀 모름. A를 도구로 씀
Layer C  <repo>/CLAUDE.md, <repo>/.claude/    프로젝트 컨텍스트만 주입
         B를 복제해 와서 도메인·스키마·금지 경로를 꽂음
핵심 규칙은 하나입니다. 아래 계층의 사정이 위로 새어 올라가지 못하게 한다. 특정 프로젝트에서만 쓰는 지식이 Layer A나 B로 올라가는 순간, 다음 프로젝트에서 그 도구를 재사용할 수 없게 됩니다. 그래서 주기적으로 계층 오염을 점검하는 스킬을 따로 둡니다.
지금 읽고 계신 이 글도 그 하네스가 처리했습니다. 메모 한 장에서 출발해 자료를 모으고 초안을 쓰고 문체를 다듬고 썸네일을 만들고 빌드를 검증하고 PR을 올리고 배포까지 확인하는 과정이 스킬 하나가 정해둔 순서대로 굴러갑니다. 제가 하는 일은 방향을 정하고 중간에 사실관계를 검수하는 쪽이에요. 어떤 스킬을 깔아야 하는지는 LLM 디자인 스킬 Top 5에 정리해 뒀습니다.
오늘 당장 할 수 있는 것
거창하게 시작할 필요 없습니다. 순서대로 하나씩만.
- 규칙 파일(CLAUDE.md / AGENTS.md)을 만들되 50줄을 넘기지 마세요. 넘으면 별도 문서로 빼고 링크만 남깁니다.
- 에이전트가 같은 실수를 두 번 하면 그때 한 줄 추가합니다. 미리 상상해서 쓰지 마세요.
- 반복 작업 하나를 골라 스킬로 만듭니다. 자주 하고 절차가 고정된 것부터. 스킬은 결국 슬래시 명령어로 불리니, 이미 있는 명령어 목록을 먼저 훑어보면 겹치는 걸 피할 수 있습니다.
- 검증을 자동화합니다. 빌드·테스트가 통과해야 커밋되는 구조면 그 자체가 가드레일입니다.
- AI가 파일을 뒤지게 두지 말고 필요한 정보를 미리 정리해 넘기세요. 우아한형제들이 95%를 줄인 지점이 여깁니다.
정리
프롬프트를 잘 쓰는 요령은 여전히 유효하지만 그것만으로 벌 수 있는 이득은 이미 다 벌었습니다. 남은 이득은 에이전트가 일할 환경을 어떻게 설계하느냐에 있습니다.
모델은 알아서 좋아집니다. 그 개선을 그대로 받아먹으려면 받아둘 그릇이 있어야 하고, 그 그릇이 하네스입니다.