에이전트가 툴을 안 쓰기로 결정한 것과 못 쓰는 것은 로그에서 똑같이 보입니다. 예외도 없고 400도 없고, 그냥 텍스트로만 답이 옵니다. 이번 주에 이걸로 반나절을 태웠습니다.
억울한 건 그 반나절 중 대부분을 엉뚱한 데서 썼다는 겁니다. 내 코드를 보고, SDK 버전을 올려보고, 시스템 프롬프트를 세 번 고쳤습니다. 정답은 정반대 방향에 있었고요. 그래서 이 글은 고치는 법보다 찾는 순서 얘기가 더 깁니다.
증상: 실패처럼 생기지 않은 실패
툴이 안 불린다는 관측 하나에 실제 원인은 최소 세 가지가 섞여 있습니다.
- 모델이 안 쓰기로 결정했다. 스키마는 멀쩡하고 설명이 약한 경우.
- 모델은 호출했는데 내 루프가
tool_use블록을 안 집었다. - 요청에 툴이 애초에 안 실렸다.
셋 다 “답이 텍스트로만 온다”로 보입니다. 구분하는 제일 싼 방법은 stop_reason이랑 블록 타입을 찍어보는 겁니다.
const res = await client.messages.create({
  model: "claude-opus-5",
  max_tokens: 16000,
  tools,
  messages,
});

console.log(res.stop_reason, res.content.map((b) => b.type));
// "end_turn" [ "text" ]              → 모델이 안 쓰기로 결정 (3~4단계로)
// "tool_use" [ "text", "tool_use" ]  → 모델은 호출했다. 내 루프 문제 (5단계로)
이 두 줄이면 절반은 여기서 끝납니다. 저는 이걸 안 찍고 두 시간을 썼습니다.
1단계: 툴이 요청에 들어가긴 했나
제일 흔하고 제일 민망한 원인입니다. 제 경우엔 구조 분해가 한 겹 어긋나 있었습니다.
const agent = new Agent({ tools });
await agent.run(task);
// TypeError: tools is not iterable
console.log(typeof tools); // "object"typeof가 "object"를 찍길래 배열인 줄 알았는데, 실제로는 { tools: [...] }를 통째로 넘기고 있었습니다. typeof는 배열과 객체를 구분 못 하니까 이 확인은 애초에 아무 의미가 없었죠.
툴 배열을 여러 모듈에서 모아 조립하는 구조라면 조립 지점에 한 줄만 박아두면 됩니다.
if (!Array.isArray(tools) || tools.length === 0) {
  throw new Error(`tools must be a non-empty array, got ${JSON.stringify(tools)?.slice(0, 80)}`);
}
호출부마다 검사하지 말고 조립 함수 한 곳에 두세요. 툴 목록 만드는 경로는 보통 하나라서 거기 하나면 다 덮입니다.
2단계: tool_choice로 이분법 진단하기
전달을 고쳤는데도 호출이 안 됐습니다. 여기서부터는 추측을 멈추고 답을 강제로 받아냅니다. tool_choice를 any로 두면 모델은 무조건 툴을 하나 이상 써야 합니다.
const res = await client.messages.create({
  model: "claude-opus-5",
  max_tokens: 16000,
  tools,
  tool_choice: { type: "any" }, // 진단용. 반드시 툴을 쓰게 강제
  messages,
});
결과는 이렇게 읽습니다.
- 400이 난다 → 스키마가 API 검증을 통과 못 한 것. 3단계로.
- 툴이 호출된다 → 스키마는 유효하다. 모델이 쓸 이유가 없다고 판단했을 뿐. 4단계로.
- 여전히 텍스트만 온다 → 툴이 요청에 안 실렸다. 1단계로 돌아가세요.
요청 한 번으로 원인 후보가 3분의 1로 줄어듭니다. 이 글에서 건질 게 하나뿐이라면 이거라고 생각합니다.
tool_choice에 쓸 수 있는 값은 공식 문서 기준 네 가지입니다.
{ type: "auto" }— 모델이 알아서 결정 (기본값){ type: "any" }— 반드시 툴 하나 이상 사용{ type: "tool", name: "search_docs" }— 특정 툴 강제{ type: "none" }— 툴 사용 금지
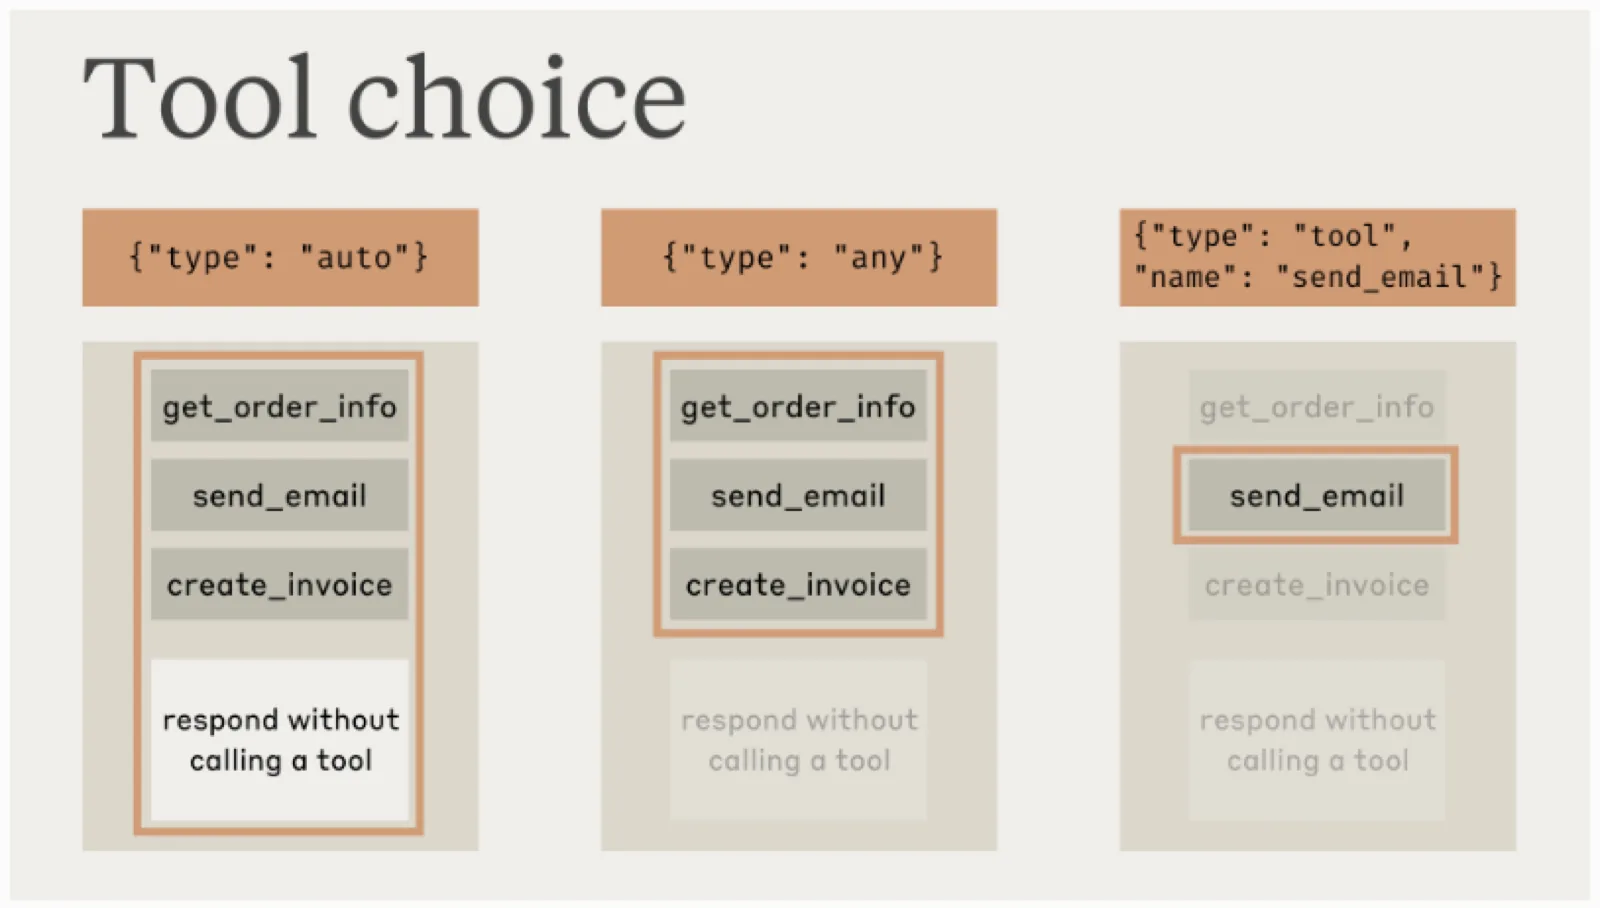
공식 문서의 다이어그램이 셋의 차이를 한 장으로 보여줍니다. auto만 “툴을 안 쓰고 답한다”는 선택지를 갖고 있고, 나머지 둘은 그 칸이 닫혀 있어요. 진단이 되는 이유가 여기 있습니다. (출처)
any랑 tool은 진단용이거나 파이프라인 고정용입니다. 일반 에이전트에 켜둔 채로 두면 그냥 답만 하면 되는 상황에도 억지로 툴을 부르니, 원인 찾았으면 auto로 되돌려놓으세요.
3단계: input_schema 체크리스트
여기가 진짜 원인이었습니다. 툴 정의는 결국 이 형태입니다.
{
  "name": "search_docs",
  "description": "사내 문서를 검색한다",
  "input_schema": {
    "type": "object",
    "properties": {
      "query": { "type": "string", "description": "검색 키워드" },
      "scope": {
        "type": "string",
        "enum": ["all", "design", "backend"],
        "description": "검색 범위. 지정하지 않으면 전체"
      }
    },
    "required": ["query"]
  }
}
확인할 것들.
input_schema.type은 반드시"object". 최상위를string이나array로 두면 모델이 인자를 만들 방법 자체가 없습니다.properties의 각 필드에description을 답니다. 필드 설명이 없으면 모델은query에 뭘 넣을지 추측하고, 추측한 만큼 이상한 인자가 들어옵니다.- 값 후보가 정해져 있으면
enum을 씁니다. 자유 문자열로 두면"디자인","design docs","Design"을 번갈아 만들어냅니다. 이건 제가 실제로 받아본 세 개입니다. required에는 진짜 필수만 넣습니다.properties에 없는 이름을required에 적으면 그 시점에 스키마가 깨집니다.- 선택 인자는
required에서 빼고 description에 기본 동작을 적어둡니다."지정하지 않으면 전체"같은 식으로요.
설명을 아무리 다듬어도 인자 모양이 안 잡히는 툴이 있습니다. 중첩된 객체를 받거나 형식이 까다로운 경우인데, 이럴 때 쓰라고 input_examples가 있습니다. 스키마 검증을 통과한 예시를 툴 정의에 같이 실어 보내는 필드입니다.
{
  "name": "get_weather",
  "input_schema": { "...": "..." },
  "input_examples": [
    { "location": "San Francisco, CA", "unit": "fahrenheit" },
    { "location": "Tokyo, Japan", "unit": "celsius" },
    { "location": "New York, NY" }
  ]
}
세 번째 예시처럼 선택 인자를 뺀 형태를 하나 넣어두면 “이건 안 넣어도 된다”가 설명보다 정확하게 전달됩니다. 주의할 점은 두 가지입니다. 예시가 input_schema를 위반하면 그 자리에서 400이 나고, 웹 검색 같은 서버 툴에는 못 씁니다. 토큰도 조금 듭니다. 간단한 예시는 2050 토큰, 중첩 객체는 100200 토큰 정도예요.
입력이 정확해야 하는 툴이면, 예를 들어 결제나 삭제 같은 거라면 strict: true를 켜세요. 툴 정의의 최상위 필드이고, tool_choice가 아니라 툴 객체에 붙습니다. 저는 이걸 처음에 tool_choice에 넣고 왜 안 되나 한참 봤습니다.
const tools: Anthropic.Tool[] = [
  {
    name: "cancel_order",
    description: "주문을 취소한다. 사용자가 명시적으로 취소를 요청했을 때만 호출한다.",
    strict: true,
    input_schema: {
      type: "object",
      properties: { order_id: { type: "string", description: "취소할 주문 ID" } },
      required: ["order_id"],
      additionalProperties: false, // strict에는 이 두 개가 필수
    },
  },
];
strict: true는 additionalProperties: false랑 required를 요구합니다. 대신 tool_use.input이 스키마대로 들어온다는 보장을 받으니 검증 코드 한 뭉치를 지울 수 있습니다.
4단계: description은 무엇이 아니라 언제
스키마가 유효한데 모델이 툴을 안 부른다면 원인은 거의 항상 description입니다. 요즘 Opus 계열은 툴을 예전보다 보수적으로 고릅니다. 굳이 안 불러도 답할 수 있으면 그냥 답합니다.
대부분의 툴 설명이 이렇게 생겼습니다.
"description": "문서를 검색한다"기능 설명은 맞는데 호출 조건이 없습니다. 모델 입장에선 지금이 그 상황인지 판단할 근거가 없죠. 이렇게 바꿨습니다.
"description": "사내 문서에서 키워드로 검색한다. 사용자가 내부 정책, 배포 절차,
온보딩 문서를 물어보거나 '문서에 뭐라고 나와 있냐'고 물을 때 호출한다.
일반 상식 질문에는 호출하지 않는다."
언제 부르는지, 어떤 표현이 신호인지, 언제 안 부르는지. 부정 조건까지 적으면 과호출도 같이 잡힙니다. 이 한 문단 고친 것만으로 호출률이 눈에 띄게 올라갔습니다.
프롬프트를 손대기 전에 툴 설명을 먼저 보세요. 시스템 프롬프트에 “필요하면 툴을 써라”를 백 번 써도, 툴이 자기를 언제 써야 하는지 말하지 않으면 소용없습니다.
툴 개수도 변수입니다. 20개를 한 번에 던지면 선택 정확도가 떨어져요. 세트를 작게 유지하거나, 이름이 비슷한 툴을 하나로 합치세요. search_docs / find_document / query_files 같은 게 한 요청에 같이 들어가 있으면 모델도 헷갈립니다.
공식 문서도 같은 얘기를 합니다. create_pr / review_pr / merge_pr처럼 쪼개지 말고 action 파라미터를 받는 툴 하나로 묶으라고요. 여러 서비스에 걸쳐 있으면 github_list_prs, slack_send_message처럼 접두사로 네임스페이스를 주라는 권장도 함께 나옵니다. 툴이 늘어날수록 선택 모호성이 비용이 되니까요.
5단계: 루프 쪽 함정 두 개
stop_reason이 "tool_use"인데 동작이 이상하면 그건 모델이 아니라 제 루프 문제입니다.
병렬 tool_use를 나눠서 응답하기
한 번의 응답에 tool_use 블록이 여러 개 올 수 있습니다. 이때 결과는 하나의 user 메시지에 전부 담아 돌려줘야 합니다.
const toolUses = res.content.filter(
  (b): b is Anthropic.ToolUseBlock => b.type === "tool_use",
);

messages.push({ role: "assistant", content: res.content });

const results = await Promise.all(
  toolUses.map(async (t) => ({
    type: "tool_result" as const,
    tool_use_id: t.id,
    content: await executeTool(t.name, t.input),
  })),
);

messages.push({ role: "user", content: results }); // 한 메시지에 전부
하나씩 따로 보내도 에러는 안 납니다. 대신 모델이 병렬 호출은 잘 안 먹히는구나를 학습해서 점점 한 번에 하나씩만 부르게 됩니다. 에러 없이 느려지는 부류라 원인 찾기가 고약합니다.
실패한 툴 결과를 드롭하기
툴이 예외를 던졌다고 결과를 빼먹으면 tool_use_id 짝이 안 맞아서 다음 요청이 거절됩니다. 실패도 결과입니다.
{
  type: "tool_result",
  tool_use_id: t.id,
  content: `검색 실패: ${err.message}`,
  is_error: true,
}
is_error: true로 돌려주면 모델이 다른 인자로 재시도하거나 사용자한테 상황을 설명합니다. 조용히 빼는 것보단 항상 낫습니다.
인자는 항상 파싱해서 쓴다
tool_use.input의 JSON 문자열 이스케이프는 모델과 버전에 따라 달라질 수 있습니다. 유니코드나 슬래시가 이스케이프돼서 올 수 있어서, 직렬화된 문자열에 정규식이나 includes()를 쓰면 어느 날 조용히 깨집니다.
// 하지 말 것
if (JSON.stringify(t.input).includes("design")) { ... }

// 할 것 — input은 이미 파싱된 객체다. 필드로 접근한다
const { query, scope = "all" } = t.input as { query: string; scope?: string };
진단 순서
1. stop_reason과 content 블록 타입을 찍는다     ← 여기서 절반이 끝난다
2. tools가 진짜 배열인지 조립 지점에서 검증한다
3. tool_choice: { type: "any" }로 이분법 진단
     400        → 스키마 문제
     호출됨     → description 문제
     텍스트만   → 툴이 안 실림
4. input_schema: type=object / 필드 description / enum / required
5. description에 언제 부르는지와 언제 안 부르는지를 쓴다
6. 루프: tool_result는 한 메시지에, 실패는 is_error로
이 순서를 머리에 두지 말고 저장소의 규칙 파일에 적어두는 편이 낫습니다. 같은 실수를 두 번 하면 한 줄 추가하는 식으로요. 그런 식으로 작업 환경 자체를 설계하는 이야기는 하네스 엔지니어링에 따로 썼습니다.
결론
우리가 보는 툴은 타입이 붙은 함수지만, 모델이 보는 건 이름 하나랑 설명 한 문단, JSON Schema 하나가 전부입니다. 그 셋이 부실하면 코드가 아무리 멀쩡해도 툴은 안 불립니다. 그리고 그 셋은 프롬프트 캐시의 프리픽스 맨 앞이기도 해서, 한 글자만 바뀌어도 그 뒤 캐시가 전부 날아갑니다. 스키마는 한 번에 고치고 고정해 두는 편이 여러모로 이득입니다.
이건 프롬프트를 스펙처럼 쓰는 이야기와 정확히 같은 문제입니다. 사람한테 일을 넘길 때 완성 기준을 안 주면 다른 게 나오는 것처럼, 모델한테 툴을 넘길 때 호출 조건을 안 주면 안 부릅니다. 그쪽 이야기는 바이브 코딩 프롬프트에 정리해 뒀습니다.
그래서 디버깅을 “내 코드 → SDK → 스키마” 순으로 하면 오래 걸립니다. stop_reason 찍고, 스키마 보고, 설명 보는 순서로 시작하면 반나절이 10분이 됩니다. 다음엔 저도 그렇게 하려고요.